Je vais être honnête. Ce projet n'est pas né d'une envie de faire de l'IA. Il est né d'une frustration, et elle est très concrète : mes candidatures de stage.
À chaque offre, je réadaptais mon CV. Sauf que l'IA qui m'aidait ne me connaissait pas, ou pas à jour. Je devais lui redonner mon contexte, mes expériences, mes projets, ce qui collait à l'offre. Et moi-même j'oubliais des détails. Alors j'allais chercher ce contexte dans une autre IA, qui l'avait gardé, pour revenir le fournir à la première. Mon profil était dispersé entre plusieurs IA, chacune avec sa version de moi.
Cet article raconte comment j'ai construit un « second cerveau » pour régler ça. Pas à pas, avec les galères et les solutions. Le résultat final m'importe moins que le chemin pour y arriver.
Les principes d'architecture
Derrière les outils, il y a une chaîne de principes. C'est elle qui structure tout le reste.
Source de vérité
      ↓
Projection
      ↓
Retrieval
      ↓
Accès contrôlé
      ↓
Écriture contrôlée
      ↓
Vérification
Le vault est la source de vérité. Tout le reste n'en est qu'une projection. L'IA ne touche jamais la source directement : elle passe par un accès contrôlé, une écriture contrôlée, puis une vérification humaine. C'est ce fil qui relie tout ce qui suit.
Le point de départ : réexpliquer ma vie à une machine
Le déclic est venu d'une question simple. Pourquoi est-ce que je perds mon temps à réexpliquer mon contexte à des outils qui, eux, ne l'oublient jamais ?
Je voulais une mémoire qui soit :
- à moi, pas enfermée dans un outil qui peut fermer demain ;
- portable, lisible par n'importe quelle IA, quelle qu'elle soit ;
- lisible et enrichissable, pour que l'IA puisse s'en servir mais aussi y ajouter, sous mon contrôle ;
- privée, pour que mes notes ne partent pas s'indexer chez un tiers.
À partir de là, l'architecture s'est imposée presque d'elle-même.
La construction, étape par étape
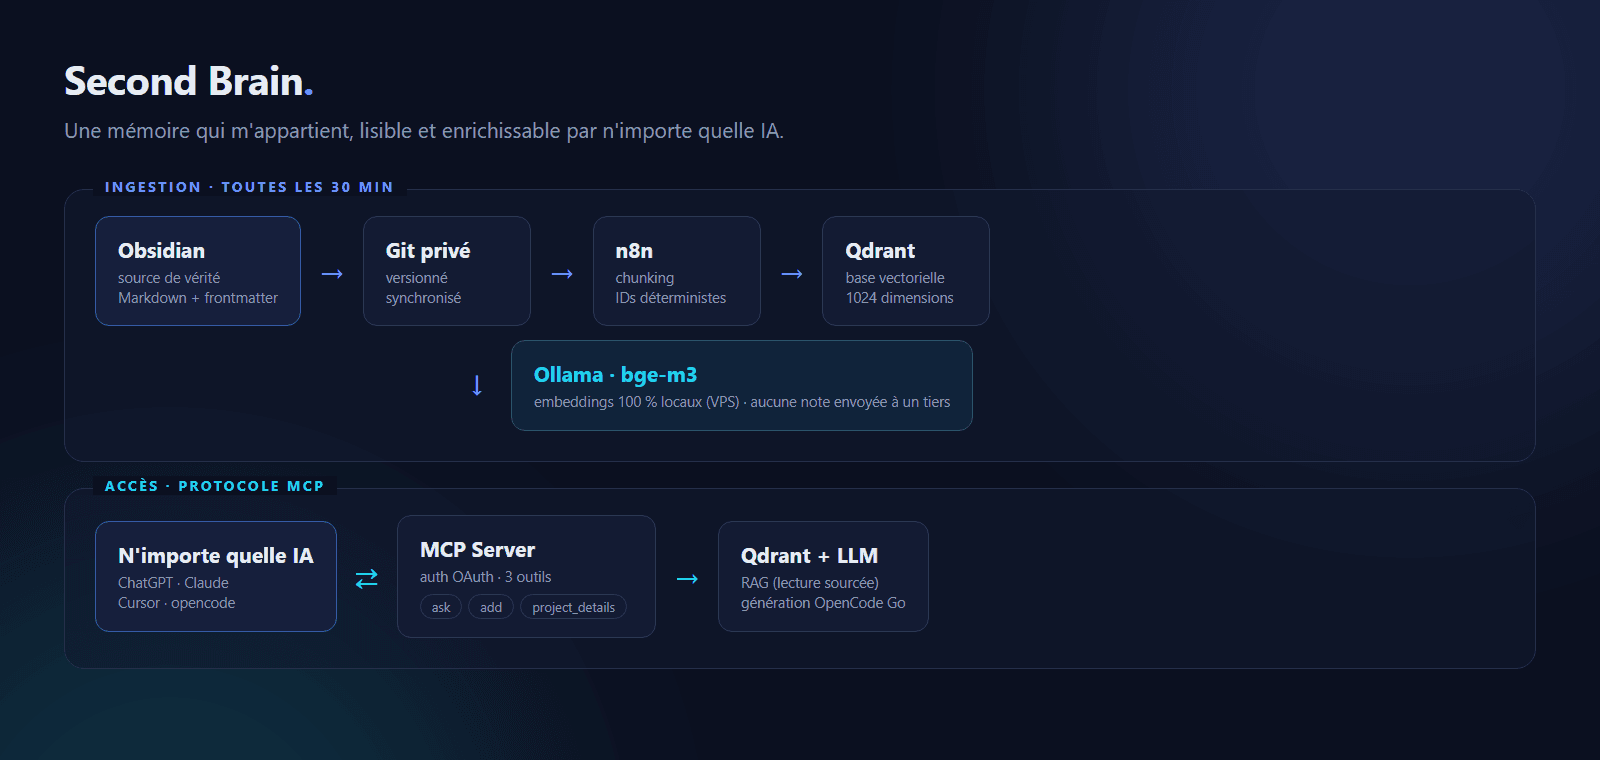
Vue d'ensemble. Le vault est la source de vérité, l'ingestion le projette dans Qdrant, et le serveur MCP l'ouvre à n'importe quelle IA.
Étape 1 : le vault Obsidian comme source de vérité
Premier choix : Obsidian. Des fichiers Markdown, un sujet par note, un frontmatter YAML (type, status, importance, tags). Pourquoi Markdown ? Parce que c'est du texte brut. Lisible par un humain, diffable, versionnable, et ça ne dépend d'aucun logiciel. Le vault vit sur mon disque et sur un repo GitHub privé, donc historique complet et synchronisation automatique.
C'est le socle. Le vault est la seule source de vérité. Tout le reste n'est qu'une projection de ce vault.
Des fichiers Markdown, un sujet par note, reliés entre eux par des liens.
Étape 2 : le pipeline d'ingestion
Pour qu'une IA puisse lire ces notes, il faut les transformer en données interrogeables par le sens. C'est le rôle d'un RAG (Retrieval-Augmented Generation) : découper les notes en morceaux (chunks), calculer pour chacun un vecteur (un nombre qui résume son sens), et les stocker dans une base vectorielle.
Mon pipeline, orchestré avec n8n que j'utilise déjà partout :
GitHub (vault privé) → décodage → chunking → embeddings → QdrantQdrant sert de base vectorielle. Elle est auto-hébergée sur mon VPS et open source. Pour les embeddings, j'utilise Ollama avec le modèle bge-m3 : il tourne en local, il est multilingue, et aucune note n'est envoyée à un tiers.
Point important : l'ingestion tourne toutes les 30 minutes. J'écris dans Obsidian, je pousse, et trente minutes plus tard c'est interrogeable. Pas de bouton à cliquer.
Le pipeline d'ingestion dans n8n : lecture du vault, découpage, filtre des chunks déjà indexés, embeddings, upsert et nettoyage.
Étape 3 : le RAG, poser une question
Une question arrive. Elle est transformée en vecteur. Qdrant retrouve les morceaux les plus proches. Un LLM répond uniquement à partir de ces morceaux, en citant les fichiers sources.
La carte des vecteurs. Chaque point est un chunk, et l'infobulle montre le lien direct entre un vecteur et son contenu.
Le pipeline de la requête dans n8n : c'est ce workflow que l'outil MCP second_brain_ask appelle.
Le choix du LLM a été mouvementé (j'y reviens dans les problèmes). Aujourd'hui, la génération passe par la passerelle OpenCode Go, avec le modèle deepseek-v4-flash-vision-exp.
Étape 4 : le serveur MCP, brancher n'importe quelle IA
C'est la pièce maîtresse, et ce qui distingue ce projet d'un simple chatbot. Le protocole MCP (Model Context Protocol) permet à n'importe quelle IA compatible de se connecter à mes outils : ChatGPT, Claude, Cursor, opencode.
J'ai construit un serveur MCP dédié qui n'expose que mes outils, jamais l'administration de n8n. Une URL suffit, et mon cerveau est branché à toutes mes IA :
https://n8n.samensteeve.com/mcp/second-brain-kbConcrètement, dans une conversation Claude, je peux écrire « interroge mon second cerveau : quels sont mes projets Laravel ? » et il va chercher dans mes notes, avec les sources.
Le point clé n'est pas le RAG en lui-même : un « Obsidian + chatbot » classique fait déjà ça. Ce qui change tout, c'est l'interopérabilité: la même base sert à ChatGPT, Claude, Cursor et opencode, sans duplication. Et le serveur n'expose que mes outils, jamais l'administration de n8n.
Le serveur MCP expose uniquement mes outils (lecture, écriture en quarantaine, lecture de la source), jamais l'administration de n8n.
Étape 5 : l'écriture contrôlée, la quarantaine
Donner à une IA la capacité d'écrire dans ma base, c'est puissant et dangereux. Une note lue par une IA, ou un contenu piégé, pourrait l'inciter à écrire n'importe quoi. Ma règle est simple : toute écriture IA passe par une quarantaine.
Une note proposée par une IA arrive avec status: pending. Elle est invisible pour la recherche tant que je ne l'ai pas validée à la main. Dans ce cadre, le pire qu'une IA compromise puisse faire est d'écrire une note que je vois, que je peux corriger ou supprimer. Et tout est versionné par Git, donc réversible.
Étape 6 : la qualité, classement, doublons, ménage
Une base qui grossit devient vite un bordel. J'ai mis trois garde-fous.
D'abord la classification automatique. Une IA qui propose une note lui donne un type, des tags et un dossier cible. Ensuite le dédoublonnage : avant d'écrire, on compare la note à l'existant. Trop similaire (au-dessus de 75 %), c'est refusé. Un peu similaire (au-dessus de 55 %), c'est un avertissement. Enfin, un housekeeping hebdomadaire : un workflow détecte les paires de notes redondantes et m'écrit un rapport à relire.
Étape 7 : plonger dans la source
Une base de connaissances, c'est bien. Mais parfois, l'IA a besoin du détail exact : un fichier précis d'un projet, l'implémentation réelle d'une fonctionnalité.
Plutôt que de tout recopier dans le vault, j'ai ajouté un troisième outil : second_brain_project_details. L'IA demande un repo (ou repo#chemin), et elle va lire la source directement sur GitHub.
Concrètement : « comment avais-je implémenté l'escrow ? », « je veux refaire cette fonctionnalité ailleurs, montre-moi comment je l'avais faite ». L'IA part chercher la vraie implémentation, dans le vrai code. Le vault reste léger, la source reste la vérité.
Aujourd'hui, cet outil est branché sur GitHub. Mais rien ne l'empêche de l'être demain sur d'autres outils : GitLab, un gestionnaire de tickets, une doc interne. C'est ça qui est puissant : la même base peut ouvrir l'IA à tout mon environnement de travail.
Étape 8 : l'authentification
Dernière brique pour que ça marche partout : l'authentification. Un token statique, c'est simple mais limité. Claude.ai web, par exemple, ne peut pas envoyer d'en-tête personnalisé. J'ai donc basculé le serveur MCP en OAuth, que n8n expose nativement avec les points de découverte standards. Résultat : n'importe quel client MCP sérieux peut se connecter en s'authentifiant normalement, sans que j'aie à lui expliquer quoi que ce soit à la main.
Étape 9 : rendre ça rapide et robuste
C'est la partie dont je suis le plus fier, parce qu'elle est invisible et qu'elle a demandé le plus de réflexion. Aujourd'hui, quand rien n'a changé, l'ingestion tourne en deux secondes au lieu de trois à six minutes. Et elle est conçue pour éviter les duplications et les pertes liées aux exécutions concurrentes.
Ce qu'il connaît de moi (et ce qu'il pourrait connaître)
Aujourd'hui, il connaît mon identité, ma carrière, mes projets, mes compétences, mes connaissances techniques et ma manière de développer. C'est tout ce que je n'ai plus à réexpliquer.
Et c'est fait pour grandir : demain, ma vie quotidienne, ma veille, mes décisions, mes idées. Une mémoire qui s'enrichit à chaque note.
Un exemple concret : un CV taillé pour une offre
Voici l'usage le plus parlant, celui qui a déclenché tout le projet.
Le contexte. Je tombe sur une offre de stage (Takima, « AI Software & DevOps Engineer », projet PopApp) autour du Green IT et de Kubernetes. Elle demande Java/Spring, React, Docker, Kubernetes et de l'IA.
La demande. Je branche une IA sur mon serveur MCP et je lui colle ce prompt :
Tu es connecté à mon second cerveau via MCP (outils : second_brain_ask, second_brain_project_details, second_brain_add).
Objectif : génère-moi un CV adapté à l'offre de stage ci-dessous, en te basant UNIQUEMENT sur ma base de connaissances. N'invente rien.

Méthode :

1. Interroge ma base avec second_brain_ask pour récupérer : mon identité, mon parcours, mes études, mes projets, mes compétences, mon CV.
2. Pour les projets les plus pertinents pour l'offre, plonge dans la source si tu as besoin du détail : second_brain_project_details, format "repo" ou "repo#chemin".
3. Sélectionne et réordonne mes projets par pertinence pour l'offre. Reformule chaque élément en puces orientées résultat.
4. Si l'offre demande une compétence que ma base ne contient pas, ne l'invente pas : signale-la comme un écart, honnêtement.

Section Green IT :
L'offre mentionne le Green IT. Relie explicitement ce thème à mon optimisation des coûts et des ressources cloud (Terraform, budgets.tf) plutôt que d'inventer une expérience Green IT que je n'ai pas. Appuie-toi uniquement sur ce qui existe dans ma base.

Contraintes :

- Faits vérifiables uniquement : pas de chiffre, date, techno ou résultat qui ne vienne pas de ma base.
- Pas de tirets cadratins, pas de flèches.
- Français, une page.
- Titre, accroche (objectif), compétences, projets, formation, langues.

Avant de rédiger, liste-moi les infos que tu as trouvées dans ma base et les écarts éventuels avec l'offre. Puis propose le CV.
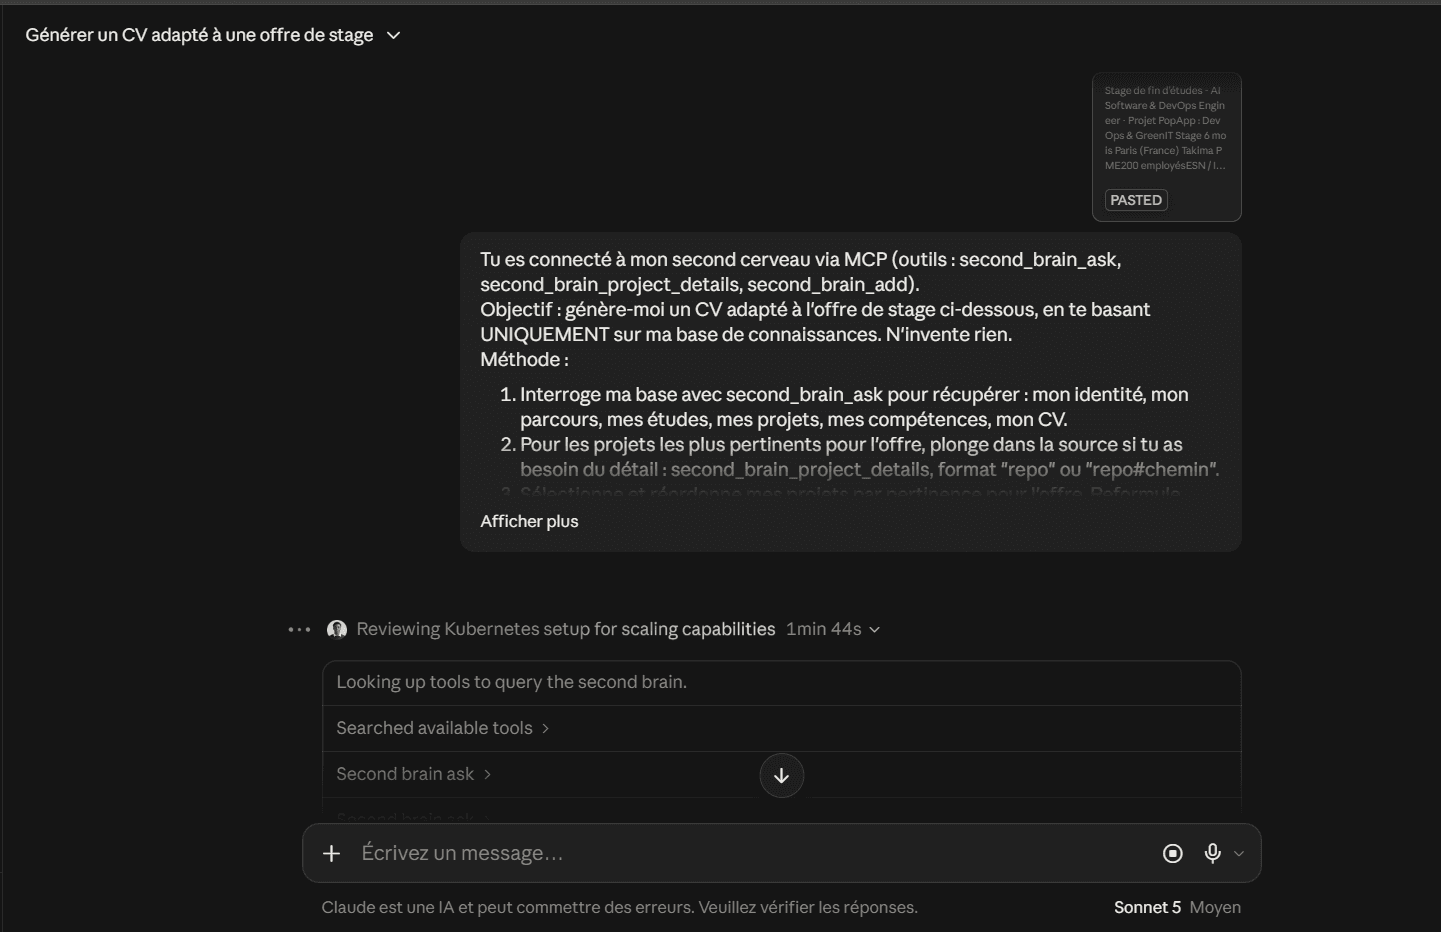
Trois choses comptent dans ce prompt : l'ordre des outils (la base d'abord, la source seulement si besoin de détail), l'interdiction d'inventer (avec obligation de signaler les écarts), et la demande de lister d'abord ce qui a été trouvé. C'est cette dernière ligne qui produit les captures ci-dessous.
Ce qui se passe ensuite :
- L'IA interroge ma base (
second_brain_ask) : identité, parcours, projets, compétences, CV. - Pour les projets clés, elle plonge dans la source (
second_brain_project_details) pour vérifier les détails réels. - Elle sélectionne et réordonne mes projets par pertinence pour l'offre.
- Elle signale honnêtement les écarts : Kotlin, etcd, Operator Framework ne sont pas dans ma base, elle ne les invente pas.
Le résultat. Un CV ciblé : Kubernetes et Terraform pour le DevOps, Spring Boot pour le Java, React pour le front, Second Brain pour l'IA, et une section qui relie honnêtement mon expérience au Green IT (maîtrise des coûts et des ressources cloud).
 1/4
Le résultat. Un CV ciblé : Kubernetes et Terraform pour le DevOps, Spring Boot pour le Java, React pour le front, Second Brain pour l'IA, et une section qui relie honnêtement mon expérience au Green IT (maîtrise des coûts et des ressources cloud).
Ce que j'ai trouvé le plus utile n'est pourtant pas le CV. C'est la liste des écarts. L'IA y pointe les manques réels de ma base : des projets décrits trop vite (React seulement via SIGGE, sans détail de ce que j'y ai fait), un projet présenté comme un cas d'étude plutôt qu'une mission réelle, des compétences absentes (Kotlin, etcd, Operator Framework). Sa remarque sur les « fichiers tronqués » méritait vérification : elle venait moins de ma base que de mon moteur de recherche. Mon indexeur découpait les notes en plein milieu des phrases, sans titre ni contexte, et ne remontait que huit morceaux par question. Le contenu était souvent là, mais mal découpé, donc introuvable. Depuis que je découpe un morceau par section en le préfixant par sa source, des infos que je croyais absentes remontent en tête des résultats, comme mon rôle sur TribuneJustice. Le cerveau ne vaut que par ce qu'on y met, mais aussi par ce qu'il sait en retrouver. C'est un début, et il rend ces trous visibles.
Les problèmes rencontrés (et comment je les ai réglés)
C'est la partie que j'aurais aimé lire quand j'ai commencé. Rien ne s'est passé comme prévu.
1. Le fournisseur LLM qui tombe à l'eau
Le problème : mon premier choix de génération ne marchait pas. Pas de clé valide d'un côté, pas de fonds de l'autre. Blocage total au moment de la génération.
La solution : réutiliser une passerelle que j'avais déjà, OpenCode Go. Mais elle exige un en-tête personnalisé, x-opencode-session, que les nœuds de modèle d'n8n n'exposent pas.
La leçon : quand un nœud ne permet pas ce dont tu as besoin, descends d'un niveau. J'ai remplacé le nœud par un simple appel HTTP direct, avec un contrôle total du payload et des en-têtes.
2. La boucle qui s'arrête toute seule
Le problème : mon ingestion utilisait splitInBatches, une boucle par note. Elle s'arrêtait prématurément dès qu'un item était vide.
La solution : abandonner la boucle pour un pipeline linéaire. Un seul flux, sans état intermédiaire fragile.
La leçon : une boucle, c'est un état de plus à gérer. Quand un flux linéaire suffit, il est plus simple et plus fiable.
3. Les embeddings qui prennent une éternité
Le problème : pas de GPU sur mon VPS. Calculer les vecteurs de 190 morceaux sur CPU, c'était environ une seconde par morceau, donc trois à six minutes à chaque exécution. Et ça recalculait tout à chaque fois, même si une seule note avait changé.
La solution : rendre l'ingestion différentielle. Chaque morceau reçoit un identifiant déterministe, un hash de son contenu. Avant de calculer, on demande à Qdrant quels identifiants existent déjà, et on n'embarque que les nouveaux ou les modifiés.
Le résultat : de trois à six minutes, on passe à deux secondes en régime stable. Seules les notes que je viens de modifier coûtent du temps.
4. Les doublons fantômes
Le problème : deux exécutions concurrentes de l'ingestion, une planifiée et une manuelle, et la base contenait deux fois les mêmes notes.
La solution : avec des identifiants déterministes, un upsert écrase au lieu d'ajouter. Deux exécutions simultanées convergent vers le même index.
5. La perte de données qui m'a agacé
Le problème : en corrigeant les doublons, j'ai introduit pire. Mon nettoyage supprimait les points absents du lot courant. Mais si une exécution avait une vue périmée du vault, elle supprimait les notes qu'une autre venait d'écrire. J'ai perdu quatre notes en testant. C'est le genre de bug qui te fait douter de tout.
La solution : horodater chaque point avec indexed_at, et ne supprimer un orphelin que s'il est antérieur au début de l'exécution. Un run concurrent, même avec une vue périmée, ne touche pas aux notes écrites après son démarrage.
La leçon : supprimer ce qui n'est plus là est une opération destructive. Sur un système concurrent, elle a besoin d'une garde temporelle. J'ai écrit ce piège noir sur blanc dans la doc du projet pour ne jamais y retomber.
6. La fuite silencieuse d'une note IA
Le problème : en fouillant, j'ai découvert qu'une note écrite par une IA était en status: active, donc indexée, alors qu'elle aurait dû être en quarantaine. Elle venait d'une ancienne version du workflow.
La solution : en plus de la quarantaine, j'ai exclu tout un dossier, celui des captures et des rapports, de l'indexation. Cette double protection empêche désormais une note IA de rejoindre l'index par ce chemin.
7. Le faux-ami qui m'a fait douter
Le problème : un nœud s'appelait « OpenRouter Model », mais pointait en réalité vers une autre passerelle. Une credential nommée « OpenAI account » n'avait rien d'OpenAI. Résultat : des heures à chercher une incohérence qui était dans les noms.
La solution : renommer selon ce que les choses font, pas selon une marque. Et en faire une règle écrite dans le projet.
La leçon : les mauvais noms coûtent plus cher qu'ils n'en ont l'air. Un nom mensonger, c'est un bug en attente.
8. « Pourquoi une IA me dit un truc et le contraire ? »
Le problème : une IA m'a affirmé que ma base était mal nommée, en s'appuyant sur une capture d'écran qui ne correspondait à rien dans mon dépôt. Un fichier qui n'a jamais existé. J'ai vérifié l'historique Git complet, zéro trace.
La solution : la règle d'or, vérifier à la source et ne jamais faire confiance à une capture. C'est la raison d'être de ce projet. Une IA qui invente, c'est une IA qui n'a pas accès à la vérité. Ici, elle n'a accès qu'à ce qui est vérifié.
À quoi ça me sert, concrètement
Le CV a été le déclencheur, mais ce n'est qu'un usage parmi d'autres. Voici ce que ça m'apporte aujourd'hui, et ce que ça m'apportera au fil du temps.
Préparer un entretien ou un stage
Je demande à n'importe quelle IA : « résume le projet X, mes choix techniques, ce que j'y ai appris ». Elle répond depuis mes notes, avec les détails exacts, pas depuis une mémoire approximative.
Candidatures, CV, portfolio
Mon contexte professionnel est prêt, à jour et interrogeable. Rédiger une candidature ou un post devient un dialogue avec ma propre base, pas une page blanche.
Freelance : répondre vite et juste
Un client pose une question technique ? Je fais plonger l'IA dans la source d'un projet (README, fichier précis) pour retrouver l'implémentation exacte, sans fouiller mon disque.
Mémoire technique quotidienne
Une leçon apprise, une décision d'archi, un piège rencontré : je le capture dans le vault. La leçon du jour devient une note interrogeable, pas un souvenir qui s'efface.
Une seule mémoire pour toutes mes IA
ChatGPT, Claude, Cursor, opencode : toutes lisent et écrivent dans la même base. Je ne réexplique plus mon contexte, je le branche.
Alimenter mes articles et mes projets
Ce que j'écris ici est nourri par le vault. Mes notes, mes retours d'expérience et mes articles ne partent plus de zéro : ils partent de ce que j'ai vécu.
Appliquer mes conventions à un nouveau projet
L'IA connaît ma manière de développer : structure, nommage, patterns, bonnes pratiques. Sur un nouveau projet, elle applique ce que j'ai déjà bien fait ailleurs, au lieu de produire du code générique.
Au-delà du travail, c'est aussi une mémoire de vie : mes projets, mes objectifs, mes démarches. Une IA qui me connaît, et qui me connaît avec ma permission, parce que c'est ma base, sur mon serveur.
Ce que ce projet m'a appris
- L'erreur est inévitable : concevoir pour l'échec (retry, idempotence, dégradation gracieuse) vaut mieux que d'espérer que rien ne casse.
- La donnée d'abord : une opération destructive a toujours besoin d'un garde-fou. Ici, un horodatage. Sinon, elle finit par mordre.
- Nommer, c'est concevoir : un composant mal nommé est un bug qui attend son heure.
- L'IA n'a pas besoin de tout mémoriser : elle doit pouvoir lire quand il faut, et n'écrire qu'avec mon accord.
- Vérifier à la source : c'est ce qui sépare une IA utile d'une IA qui invente avec aplomb.
Et après ?
Le socle est solide, mais rien n'est figé. Ce qui vient : une interface de chat (Telegram ou WhatsApp) pour interroger le cerveau sans ouvrir un client MCP, la capture automatique (veille, idées) pour que la base se nourrisse toute seule, et toujours plus de notes de vie. Parce qu'au fond, ce projet n'est pas un projet d'IA. C'est une mémoire que je construis, morceau par morceau.
Si tu construis un projet similaire, commence simple, mets des garde-fous avant d'avoir mal, et documente chaque piège. Les problèmes que j'ai listés ici, tu les rencontreras aussi. Autant qu'ils te servent.